---
title: AI聚合网页版Open WebUI:一条命令把本地Ollama变成全设备可用的聊天站
description: 用一条 docker 命令在 NAS 上部署 Open WebUI,接入局域网内的 Ollama,实现手机、平板、电脑共用一套网页版 AI 聊天界面,本地运行、数据不出内网。
outline: deep
category: 教程
date: 2026-11-13
tags:
- Open WebUI
- Ollama
- Docker
- 本地大模型
- 飞牛NAS
readingTime: 6 分钟
---
# AI聚合网页版Open WebUI:一条命令把本地Ollama变成全设备可用的聊天站
> 📺 本图文教程由视频整理而成,对应的参考视频:[AI聚合网页版Open WebUI~本地大模型Ollama绝配~](https://www.bilibili.com/video/BV1czd5BEEFb)。如需查看更详细、更具体的操作演示,可观看原视频。
> 场景:已经在某台电脑(如 Mac mini)上装好 Ollama 并下载了本地模型,但每换一台设备就要装一次客户端(Cherry Studio 之类)才能聊天。想在局域网里架一个网页版入口,手机、平板、其它电脑打开浏览器就能用同一个模型。
> 提示:本教程配套的操作文档,可在[好用斋官网](https://haoyongzhai.com) → [网盘分享](https://haoyongzhai.com/netdisk)(提取码 540)中下载。
Open WebUI 是一个自托管的 AI 聚合界面,前端体验接近 ChatGPT,后端可以直接对接 Ollama、OpenAI 兼容接口等多种模型服务。项目在 GitHub 上已有 132K Star,官网见 [openwebui.com](https://openwebui.com/),源码与 Release 见 [open-webui/open-webui](https://github.com/open-webui/open-webui)。
## 第一步:获取配套文档
配套文档共三部分:Docker CLI 命令、Open WebUI 的官网与 GitHub 地址、好用斋官网。命令直接复制即可用,后两部分按需查阅,想拿最新版本就去官网或 Release 页。
## 第二步:读懂这条 docker 命令
```bash
docker run -d \
-p 3030:8080 \
-e OLLAMA_BASE_URL=http://192.168.31.222:11434 \
-e RAG_EMBEDDING_MODEL="" \
-e RAG_TEMPLATE="" \
-v /vol1/1000/tools/open-webui:/app/backend/data \
--name open-webui \
--restart always \
ghcr.nju.edu.cn/open-webui/open-webui:main
```
| 参数 | 说明 |
| --------------------------- | ---------------------------------------------------------------------------------------------------- |
| `-d` | 容器后台运行 |
| `-p 3030:8080` | 端口映射,容器内固定 `8080`,宿主机用 `3030`。8080 被占用太多,可改成自己喜欢的端口 |
| `-e OLLAMA_BASE_URL` | Ollama 的 API 地址,**必须改成你自己那台安装Ollama设备的 IP**,端口 `11434` 是 Ollama 默认端口不用动 |
| `-e RAG_EMBEDDING_MODEL=""` | 置空,跳过启动时自动下载 RAG 向量模型 |
| `-e RAG_TEMPLATE=""` | 置空,同上,避免首启动去 Hugging Face 拉模型 |
| `-v ...:/app/backend/data` | 数据目录映射,冒号后面的容器内路径不能改,只改冒号前的本地路径 |
| `--name open-webui` | 容器名称,可自定义 |
| `--restart always` | 重启策略,飞牛用 `always`;其它系统建议 `unless-stopped` |
| `ghcr.nju.edu.cn/...` | 镜像地址,南京大学镜像源加速,国内拉取更快 |
::: warning 注意
`OLLAMA_BASE_URL` 里的 IP 是「安装 Ollama 那台设备」的地址,不是 NAS 的地址。如果 Ollama 还没装,参考前面的 Ollama 安装视频。另两条 RAG 环境变量不置空的话,首次启动会去 Hugging Face 下载模型,启动会非常慢。
:::
## 第三步:执行命令部署
SSH 登录 NAS,执行 `sudo -i` 切换到 root:
```bash
sudo -i
```
输入管理员密码时屏幕不会有任何显示,输完直接回车。然后右键粘贴上面的整条 docker 命令并回车。镜像已拉取过的话会直接创建容器。
## 第四步:确认容器正常运行
打开飞牛 NAS,进入「Docker」→「容器」,`open-webui` 已经在列表中运行。点该容器右侧的端口号,浏览器会打开 `http://NAS的IP:3030`。
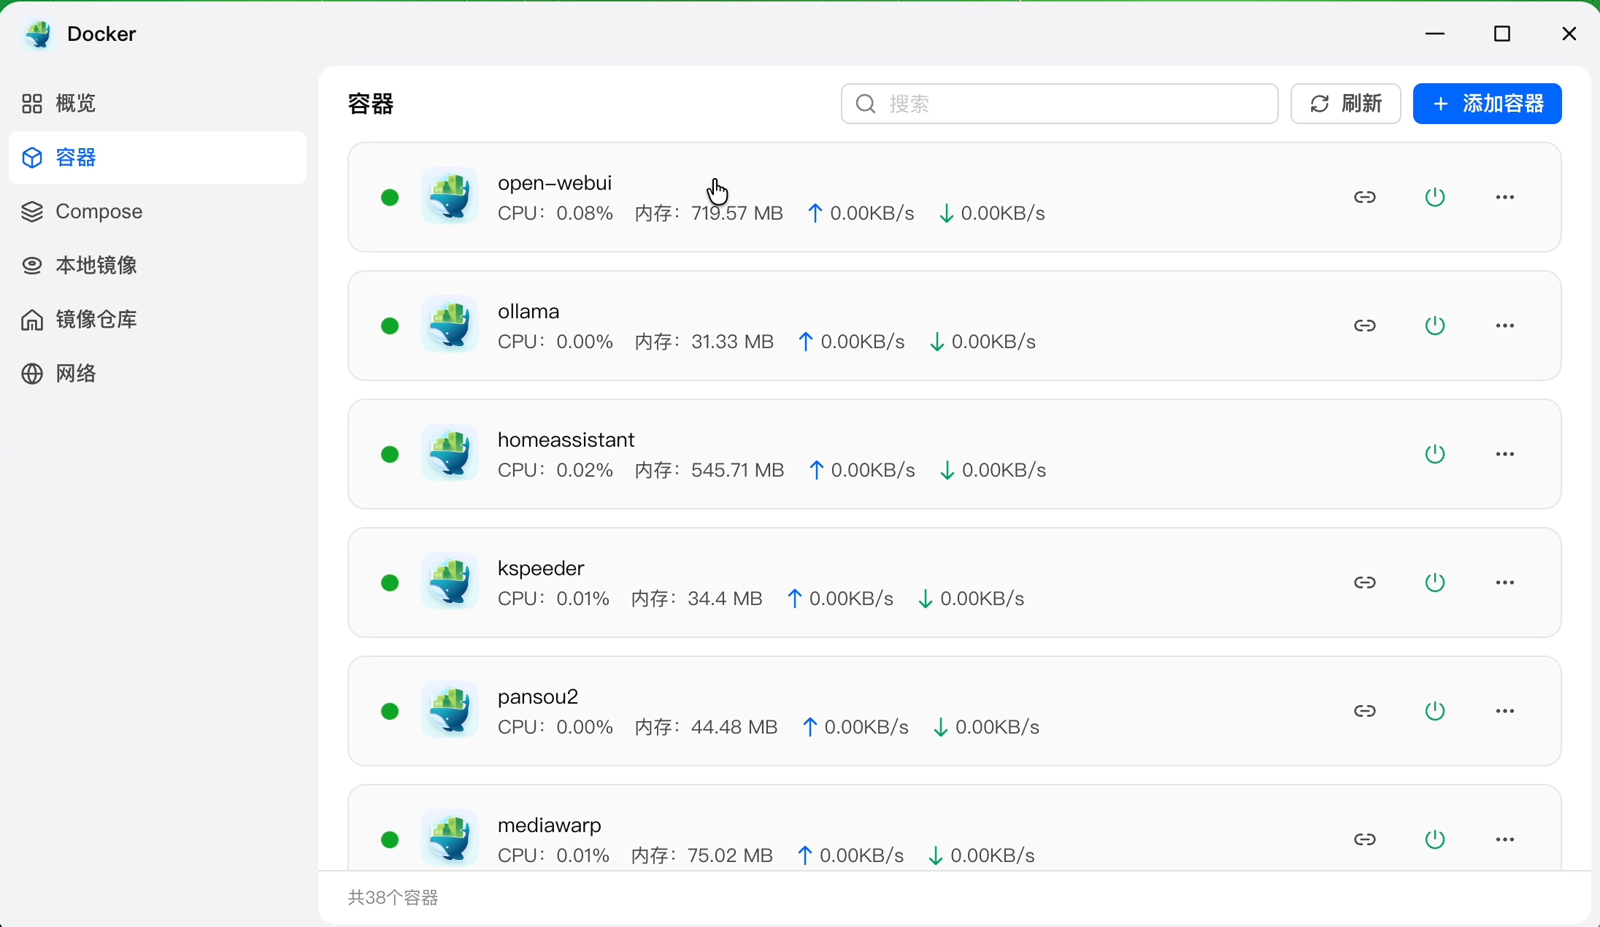 页面能正常打开就说明部署成功。若一直转圈,先检查那两条 RAG 环境变量是否置空、`OLLAMA_BASE_URL` 是否填对。
## 第五步:创建管理员账号
首次访问会进入「开始使用 Open WebUI」页面,填写名称、电子邮件、密码,点「创建管理员账号」。
这里的账号密码是随意填的,不会联网验证,本质是建立一个本地账户。创建完成后点「确认开始使用」。
## 第六步:选择模型开始对话
进入主界面后,Open WebUI 已经自动读取到 Ollama 里的模型列表。左上角下拉框可以切换,例如 `gemma4:e2b`、`qwen2.5:7b`、`qwen3.5:4b`。
`gemma4`、`qwen3.5:4b` 属于思考模型,回答前会先输出思考过程,日常聊天略显拖沓;纯聊天场景选 `qwen2.5:7b` 更顺手。
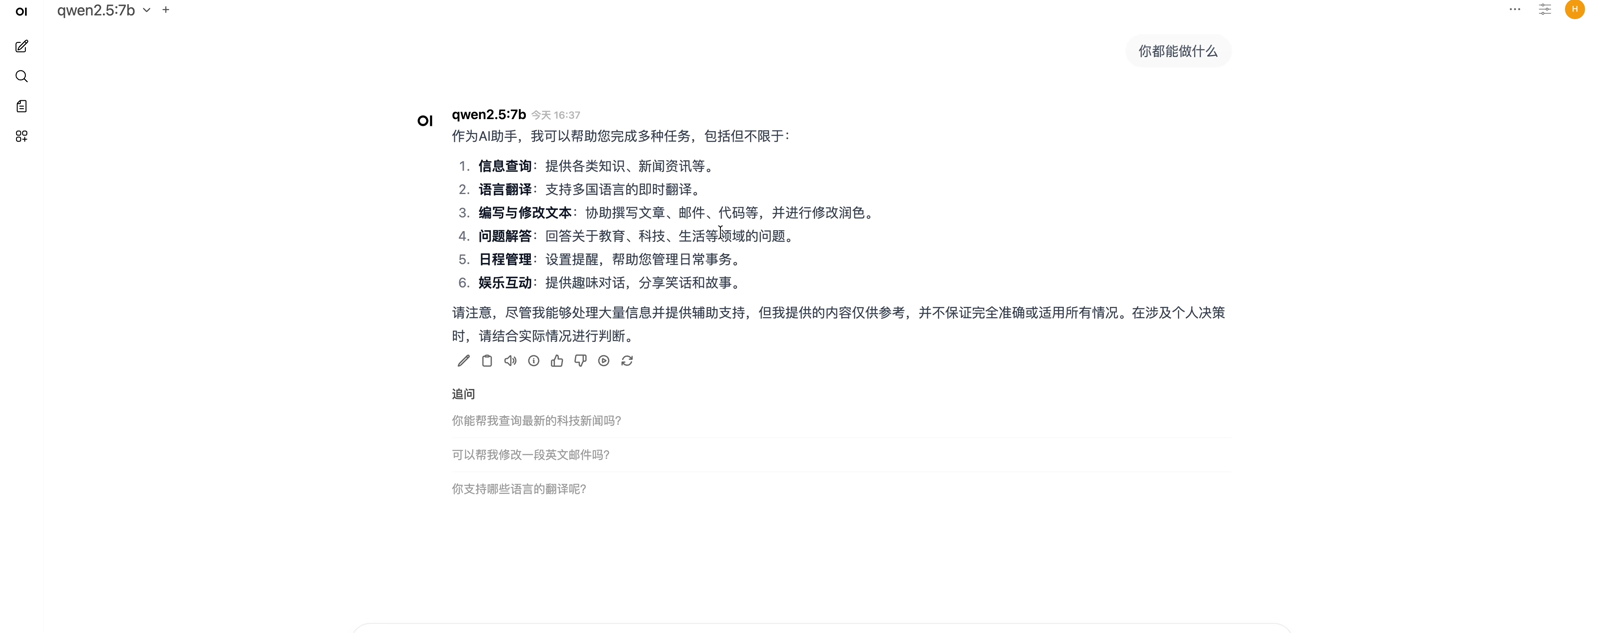 直接提问即可,例如「你都能做什么」。实测 7B 模型生成速度约 18 token/s,而正常人阅读速度约 13 token/s,已经够用。每条回答下方有朗读、复制按钮,点开还能看到 token 统计等详细信息。
::: tip 说明
本地 7B 模型的智商比不过在线大模型,但胜在免费、可离线、数据不出内网。隐私敏感的内容放本地跑,复杂任务再交给在线模型,按需组合即可。
:::
## 第七步:局域网内其它设备访问
部署完成后,局域网内所有设备(手机、平板、其它电脑)直接用浏览器访问:
```text
http://NAS的IP:3030
```
地址就是安装 Open WebUI 那台飞牛 NAS 的 IP,加上你在 `-p` 里设置的宿主机端口。无需在每台设备上再装客户端。
## 第八步:其它功能(可选)
界面左侧还有笔记、知识库等入口。简单的笔记需求可以直接用;如果想做完整的个人知识库,Open WebUI 不是最优解,普遍认为 Anything LLM 更合适。
作者会把OpenWebUI加进 Docker 懒人包的「AI工具」一栏,可以使用懒人包直接安装。
## 总结
1. Open WebUI 解决的是「Ollama 只有本机能用」的问题,一个网页入口覆盖全局域网设备。
2. 部署只需一条 docker 命令,核心是三处改动:`OLLAMA_BASE_URL` 的 IP、`-p` 的宿主机端口、`-v` 的本地数据路径。
3. 两条 RAG 环境变量置空,可跳过 Hugging Face 模型下载,启动速度差别非常大。
4. 端口映射冒号右边、路径映射冒号右边都不能改,只改左边。
5. 管理员账号是本地账户,随意填写,不联网校验。
6. 日常聊天优先选非思考型模型(如 `qwen2.5:7b`),响应更快。
7. 重启策略飞牛用 `always`,其它系统用 `unless-stopped`。
## 参考视频
- [AI聚合网页版Open WebUI~本地大模型Ollama绝配~](https://www.bilibili.com/video/BV1czd5BEEFb)
## 好用斋官网
[好用斋官网](https://haoyongzhai.com)|[网盘分享](https://haoyongzhai.com/netdisk)

